Un concurrent apparaît systématiquement dans les réponses de ChatGPT lorsque vos prospects interrogent l’outil sur votre secteur d’activité. Votre entreprise, elle, reste absente. Cette observation, partagée par de nombreux responsables marketing en septembre 2026, révèle une réalité désormais documentée : les moteurs de réponses IA ne citent pas au hasard. Ils privilégient des catégories spécifiques de contenus, avec des préférences distinctes selon les plateformes.
L’analyse de plus de 17 millions de citations collectées entre 2025 et 2026 permet d’identifier cinq typologies de contenus systématiquement favorisés, ainsi que les différences stratégiques entre ChatGPT, Gemini et Perplexity. Ces écarts ouvrent des opportunités ciblées pour les entreprises de taille moyenne, à condition de comprendre les mécanismes de sélection à l’œuvre.
- Les contenus factuels et structurés dominent les citations IA
- Pourquoi les études et rapports chiffrés sont-ils systématiquement privilégiés ?
- Quelles différences entre ChatGPT, Gemini et Perplexity dans leurs citations ?
- Les formats longs et approfondis surpassent les contenus courts optimisés SEO
- Comment les petites marques peuvent-elles rivaliser avec les leaders établis ?
- Les critères techniques qui favorisent la citation par les IA génératives
- Prioriser les investissements éditoriaux selon les ressources disponibles
Les contenus factuels et structurés dominent les citations IA
Réponse directe : Les IA génératives citent en priorité cinq grandes catégories de contenus : les études chiffrées avec méthodologie transparente, les rapports sectoriels documentés, les guides approfondis dépassant 1 500 mots, les FAQ structurées avec balisage sémantique, et les pages produits détaillées comportant des spécifications techniques précises.
Cette hiérarchie, observée sur les principales plateformes en septembre 2026, repose sur des caractéristiques communes : une structuration forte facilitant l’extraction d’informations, la présence de données vérifiables réduisant les risques d’hallucination, une profondeur argumentaire permettant de répondre à des requêtes complexes, et une mise à jour régulière attestant de la fraîcheur du contenu.
Distinguer un contenu cité d’un contenu simplement indexé s’avère déterminant. Une page peut être crawlée et analysée par les modèles de langage sans pour autant apparaître comme source visible dans les réponses générées. La citation, elle, matérialise une sélection active : le moteur conversationnel juge le contenu suffisamment fiable et pertinent pour l’associer publiquement à sa réponse.
Les exemples concrets illustrant ces cinq catégories révèlent des formats précis. Une étude chiffrée type baromètre du marketing digital 2026, mentionnant son échantillon de 500 entreprises et sa période de collecte au premier trimestre, répond aux critères observés. Un rapport sectoriel analysant l’état du SaaS B2B en France, publié par un acteur reconnu avec sources primaires identifiées, entre également dans cette logique. Un guide d’implémentation technique dépassant 2 000 mots, détaillant chaque étape avec captures d’écran et code commenté, correspond au format long valorisé. Une FAQ répondant aux quinze questions les plus fréquentes d’un secteur, balisée avec le vocabulaire FAQPage de Schema.org, bénéficie d’une extraction facilitée.
Depuis septembre 2026, l’évolution la plus notable concerne la baisse de corrélation entre l’autorité de domaine classique et la visibilité dans les réponses IA. Une synthèse de plus de vingt études indépendantes publiée en juillet 2026 montre que cette corrélation n’atteint que 0,27 à 0,33 selon les plateformes, contre des niveaux supérieurs à 0,50 pour le référencement Google traditionnel. Cette rupture méthodologique ouvre des opportunités pour les entreprises disposant de contenus structurés et factuels, même sans autorité de domaine historique élevée.
Pourquoi les études et rapports chiffrés sont-ils systématiquement privilégiés ?
Les données chiffrées offrent aux modèles de langage des ancrages factuels vérifiables qui réduisent les risques d’hallucination. Lorsqu’une IA générative doit répondre à une question complexe, elle privilégie les sources lui permettant d’extraire des informations précises plutôt que des affirmations qualitatives générales. Une étude mentionnant qu’un marché a progressé de 23 % en 2025 constitue une référence plus solide qu’un article affirmant simplement que ce marché croît fortement.
Les critères de validation des sources chiffrées par les IA reposent sur quatre piliers. La méthodologie transparente figure en première position : mentionner l’échantillon interrogé, la période de collecte et la marge d’erreur renforce la crédibilité perçue par les algorithmes de sélection. La présence de sources primaires mentionnées explicitement constitue le deuxième critère : citer l’organisme ayant produit les données originales plutôt que se contenter d’une reprise secondaire améliore le niveau de confiance. La période de collecte précise permet aux modèles d’évaluer la fraîcheur et la pertinence temporelle des informations. L’échantillon détaillé, enfin, aide à contextualiser la portée des résultats.
La distinction entre données primaires et données secondaires influence directement la probabilité de citation. Les enquêtes internes menées auprès de vos propres clients, même sur des échantillons modestes de quelques dizaines de répondants, génèrent des insights exclusifs qu’aucune autre source ne peut fournir. Cette exclusivité compense largement un échantillon réduit. À l’inverse, l’agrégation de sources tierces sans valeur ajoutée analytique peine à émerger face aux publications originales.
Les formats de présentation des données jouent également un rôle déterminant. Les tableaux structurés avec en-têtes explicites facilitent l’extraction automatique. Les graphiques accompagnés des données sources brutes permettent une double validation. Les listes chiffrées hiérarchisées simplifient le parcours machine. Les comparaisons temporelles montrant des évolutions sur plusieurs périodes renforcent la profondeur analytique du contenu.
Une analyse portant sur 25 millions de liens cités par ChatGPT, Claude et Gemini indique que 84 % des citations proviennent de contenus éditoriaux gagnés, contre seulement 0,3 % de contenus sponsorisés. Cette donnée souligne l’importance de la qualité éditoriale et de la valeur de preuve dans les mécanismes de sélection des IA génératives, par rapport aux investissements publicitaires.
Quelles différences entre ChatGPT, Gemini et Perplexity dans leurs citations ?
Les trois principales plateformes conversationnelles ne partagent pas les mêmes comportements de sourcing. Perplexity privilégie nettement les sources académiques et institutionnelles : les domaines en .edu, .gov et .org représentent une proportion significativement plus élevée dans ses citations que chez ses concurrents. Les rapports de recherche, les publications scientifiques vulgarisées et les ressources pédagogiques structurées bénéficient d’une visibilité accrue sur cette plateforme.
ChatGPT favorise les contenus conversationnels longs et les formats pédagogiques. Les articles dépassant 1 500 mots structurés en questions-réponses, les FAQ exhaustives avec balisage approprié, les guides tutoriels détaillant chaque étape d’un processus complexe, et les contenus adoptant un ton explicatif accessible obtiennent de meilleurs résultats. L’étude Yext portant sur 17,2 millions de citations confirme que 48,73 % des sources citées par ChatGPT proviennent de plateformes tierces comme Yelp, TripAdvisor ou des annuaires professionnels, révélant une logique de présence multi-canaux.
Gemini cite davantage les pages corporate de marques établies et les contenus liés à l’écosystème Google. Les communiqués officiels, les pages produits institutionnelles détaillées, et les ressources publiées par des organisations reconnues bénéficient d’une meilleure visibilité. Cette préférence s’explique en partie par l’intégration native de Gemini aux services Google et par les données d’indexation disponibles via le moteur de recherche.
Les implications stratégiques pour les PME découlent directement de ces profils différenciés. Une entreprise disposant de capacités de production d’études ou de recherches sectorielles gagne à prioriser Perplexity. Une structure dont la force réside dans la production éditoriale pédagogique et les contenus longs trouvera un terrain favorable avec ChatGPT, la plateforme la moins corrélée aux signaux d’autorité classiques et donc la plus accessible aux petites marques. Une entreprise ayant construit une marque structurée avec une présence institutionnelle affirmée pourra capitaliser sur Gemini.
| Plateforme | Types de sources privilégiés | Formats favorisés | Opportunité PME |
|---|---|---|---|
| Perplexity | Académique, institutionnel (.edu, .gov, .org) | Rapports de recherche, études sectorielles, publications scientifiques vulgarisées | Produire des contenus type étude ou recherche sectorielle propriétaire |
| ChatGPT | Conversationnel long, pédagogique, plateformes tierces | Articles 1500+ mots, FAQ structurées, guides tutoriels, Q&A approfondies | Miser sur la profondeur éditoriale et les formats pédagogiques accessibles |
| Gemini | Corporate, marques établies, écosystème Google | Pages institutionnelles, communiqués officiels, fiches produits détaillées | Structurer sa présence marque et capitaliser sur les canaux Google |
Les observations terrain recueillies par Qlint auprès de l’écosystème des agences françaises spécialisées en référencement IA confirment ces différences comportementales. Les entreprises ayant adapté leur stratégie de contenu en fonction du profil de plateforme aligné avec leurs ressources internes rapportent des taux de citation supérieurs à celles ayant déployé une approche indifférenciée.
Les formats longs et approfondis surpassent les contenus courts optimisés SEO
Les contenus cités par les IA génératives dépassent majoritairement le seuil de 1 500 mots, avec une surreprésentation des articles situés entre 2 000 et 3 000 mots. Cette observation, cohérente sur les trois principales plateformes, marque une rupture avec le référencement traditionnel où des contenus de 600 à 800 mots bien optimisés peuvent atteindre des positions satisfaisantes.
La longueur seule ne suffit cependant pas. Un article de 2 500 mots pratiquant le remplissage SEO avec des paragraphes répétitifs et une faible densité informationnelle obtient des résultats inférieurs à un contenu de 1 200 mots exhaustif sur un angle précis. La profondeur argumentaire prime sur le simple volume de mots. Cette profondeur se caractérise par le traitement de multiples facettes d’un sujet, l’anticipation des questions secondaires, la présence d’exemples et de contre-exemples, et la mention explicite des nuances et limites.
Les critères de profondeur valorisés par les moteurs conversationnels diffèrent des pratiques SEO courantes. Là où Google tolère des contenus ciblant une requête unique avec une réponse directe suivie de quelques paragraphes de développement, ChatGPT, Gemini et Perplexity privilégient les ressources leur permettant de synthétiser des réponses complexes nécessitant plusieurs angles d’analyse. Un guide traitant non seulement du sujet principal mais aussi des objections courantes, des cas d’usage différenciés et des contre-indications éventuelles répond mieux à ces attentes.
Cette exigence de profondeur répond à la logique fonctionnelle des IA génératives. Contrairement à un moteur de recherche qui renvoie vers des pages, un moteur conversationnel synthétise une réponse originale en s’appuyant sur plusieurs sources. Les contenus riches et nuancés offrent davantage de matière exploitable pour cette synthèse, augmentant mécaniquement leur probabilité d’être cités.
Comment les petites marques peuvent-elles rivaliser avec les leaders établis ?
L’objection selon laquelle seules les grandes marques obtiennent des citations dans les réponses IA repose sur une perception partiellement erronée. Si les marques établies bénéficient d’une visibilité structurelle, quatre leviers accessibles permettent aux PME de compenser ce désavantage initial.
- Niche sémantique précise : dominer un micro-sujet spécialisé délaissé par les acteurs généralistes
- Données primaires exclusives : produire des enquêtes internes et baromètres propriétaires même avec échantillons modestes
- Fraîcheur de publication : publier rapidement sur sujets émergents ou évolutions réglementaires récentes
- Structure conversationnelle : développer FAQ exhaustives et formats pédagogiques valorisés par ChatGPT
Le premier levier, la niche sémantique précise, repose sur un constat documenté : les IA génératives citent les sources les plus spécialisées sur un angle étroit. Une PME SaaS RH publiant un guide exhaustif sur la conformité RGPD spécifique aux entreprises de moins de dix personnes dispose d’un avantage concurrentiel face aux guides généralistes RGPD des grandes marques. Cette stratégie transforme la taille réduite en atout de spécialisation.
Les données primaires exclusives constituent le deuxième levier accessible. Un baromètre trimestriel interrogeant cinquante décideurs sur un sujet de niche, accompagné d’une méthodologie transparente, génère une valeur de preuve unique. Même avec un échantillon modeste, l’exclusivité de l’insight compense l’absence d’autorité de domaine historique. Les retours terrain exclusifs, les analyses de cas clients anonymisés et les observations sectorielles propriétaires entrent dans cette catégorie.
La fraîcheur de publication exploite l’agilité éditoriale des petites structures. Sur des sujets émergents ou des évolutions réglementaires récentes, publier un contenu à jour sous quarante-huit heures surpasse l’autorité de marques établies publiant plusieurs semaines après. Une agence spécialisée fintech ayant publié une analyse détaillée de la réglementation MiCA dès son entrée en vigueur peut être citée avant des institutions bancaires ayant publié tardivement.
La structure conversationnelle, quatrième levier, capitalise sur le profil de ChatGPT identifié précédemment. Développer une FAQ de vingt-cinq questions sur un sujet de niche, structurée avec le balisage FAQPage approprié, permet de apparaître dans les moteurs de réponses sans budget majeur. Ce format reste maîtrisable par une équipe marketing réduite.
Les insights sectoriels partagés par Qlint auprès de PME ayant obtenu des citations avec ces leviers confirment leur efficacité opérationnelle. Les entreprises ayant investi dans des contenus de niche approfondis plutôt que dans des sujets généralistes saturés rapportent des résultats tangibles en termes de visibilité conversationnelle, indépendamment de leur autorité de domaine initiale.
Les critères techniques qui favorisent la citation par les IA génératives
Au-delà de la qualité éditoriale, plusieurs éléments techniques influencent la probabilité qu’un contenu soit sélectionné et cité par les moteurs conversationnels. Le balisage sémantique et la structuration du code HTML facilitent l’extraction automatique d’informations par les algorithmes de traitement du langage naturel.
Le rôle du balisage Schema.org
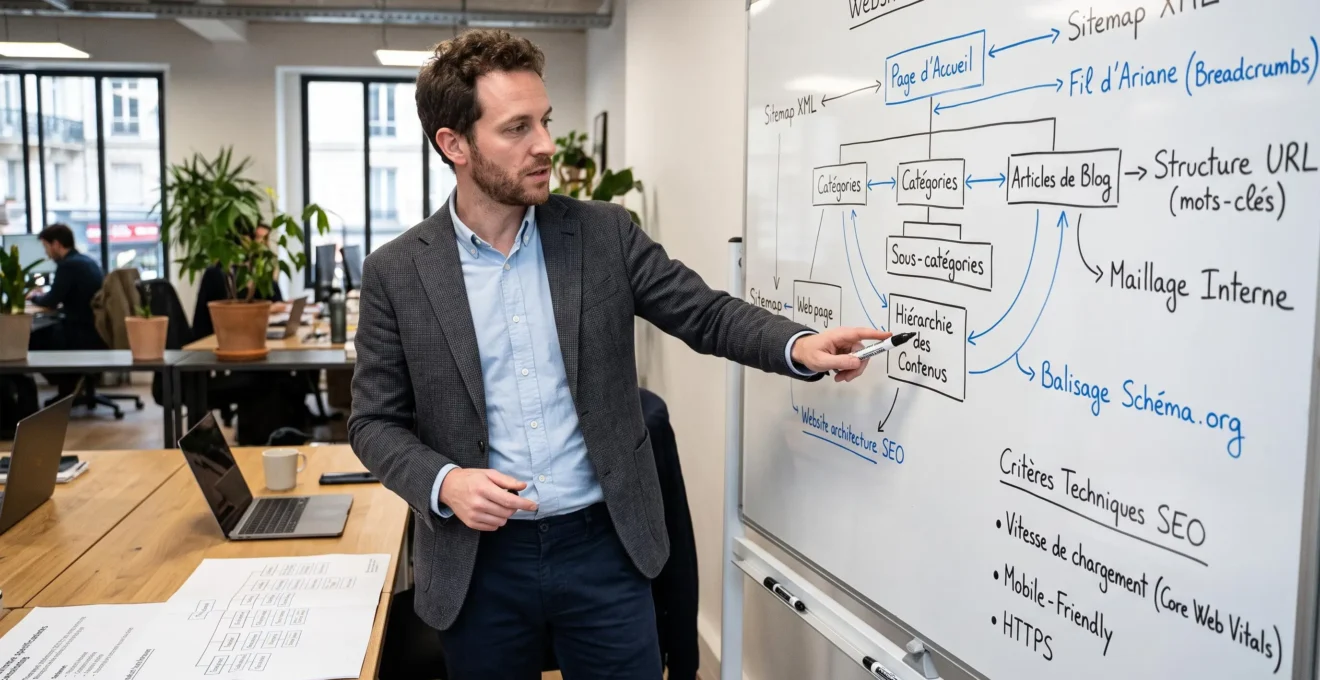
Le vocabulaire Schema.org permet de décrire explicitement la nature et la structure des informations présentes sur une page. Les types Article, FAQPage, HowTo et Dataset figurent parmi les plus pertinents pour le référencement IA. Ils fournissent aux modèles de langage des métadonnées structurées facilitant la compréhension du contenu.
Schema.org : les 4 types prioritaires pour le GEO
- Article : pour les contenus éditoriaux longs avec auteur, date de publication et organisation éditrice identifiés
- FAQPage : pour les pages de questions-réponses structurées facilitant l’extraction par ChatGPT
- HowTo : pour les guides procéduraux détaillant des étapes séquentielles
- Dataset : pour les jeux de données et études chiffrées avec méthodologie documentée
Une étude Ahrefs portant sur 1 885 pages ayant ajouté du balisage JSON-LD entre août 2025 et mars 2026 nuance cependant l’impact direct de Schema.org. Les citations par Google AIO, Google AI Mode et ChatGPT n’ont presque pas évolué dans les trente jours suivant l’implémentation du balisage. Ce résultat invite à considérer Schema.org comme un facilitateur à moyen terme plutôt qu’un levier immédiat, sans exclure ses bénéfices indirects via une meilleure indexation.
Structure Hn et lisibilité machine
Une hiérarchie de titres claire et sémantique, respectant la progression H1, H2, H3 sans saut de niveau, facilite le parcours automatique du contenu. Les IA génératives identifient plus aisément les sections pertinentes à extraire lorsque chaque titre résume précisément le contenu qu’il introduit. Les formulations descriptives l’emportent sur les titres créatifs mais vagues.
Les critères techniques complémentaires comprennent la vitesse de chargement et l’accessibilité du site, bien que leur impact diffère du référencement traditionnel. Un site rapide et accessible facilite le crawl et l’extraction, sans constituer un facteur de classement direct. Le sitemap XML à jour et un fichier robots.txt optimisé demeurent des prérequis basiques pour la découverte du contenu. Le protocole HTTPS et un certificat SSL valide renforcent les signaux de confiance technique, particulièrement valorisés par les IA soucieuses de la fiabilité des sources citées.
Les IA génératives citent-elles les contenus derrière paywall ou espaces membres ?
Les contenus nécessitant une authentification ou un paiement sont rarement cités, les IA s’appuyant principalement sur des ressources accessibles publiquement lors de leur phase de crawl et d’indexation. Les exceptions concernent des partenariats directs entre éditeurs et plateformes IA.
Faut-il un volume de trafic minimal pour être cité par ChatGPT ou Gemini ?
Non, le volume de trafic n’apparaît pas comme un critère déterminant. La corrélation entre autorité de domaine classique et citations IA reste faible (0,27 à 0,33), permettant à des sites à trafic modeste mais contenus structurés et factuels d’obtenir des citations.
Les IA citent-elles les contenus en français aussi souvent que ceux en anglais ?
Les contenus francophones de qualité équivalente obtiennent des citations sur requêtes en français, bien que le volume global de contenus anglophones reste supérieur. Produire des ressources approfondies en français sur des sujets de niche peut constituer un avantage concurrentiel face à la saturation anglophone.
Combien de temps après publication un contenu peut-il être cité par Perplexity ou ChatGPT ?
Les délais varient selon les plateformes et leurs cycles de mise à jour. Certains contenus apparaissent en quelques jours, d’autres nécessitent plusieurs semaines. La fraîcheur thématique (sujets émergents, actualités sectorielles) accélère généralement le processus d’indexation et de citation.
Prioriser les investissements éditoriaux selon les ressources disponibles
Les cinq catégories de contenus privilégiés par les IA génératives — études chiffrées, rapports sectoriels, guides approfondis, FAQ structurées et pages produits détaillées — ne nécessitent pas toutes les mêmes ressources de production. Les entreprises disposant de capacités d’analyse interne peuvent concentrer leurs efforts sur la production d’études propriétaires exploitant leurs données clients. Celles dont la force réside dans l’expertise métier gagneront à développer des guides longs dépassant 2 000 mots sur des angles de niche précis.
La cartographie comparative révèle trois portes d’entrée différenciées. Perplexity favorise les contenus à dimension académique ou institutionnelle, accessibles aux entreprises capables de produire des recherches sectorielles documentées. ChatGPT privilégie les formats conversationnels longs et pédagogiques, maîtrisables par des équipes marketing réduites via des FAQ exhaustives et des guides tutoriels. Gemini cite davantage les pages corporate structurées, avantageant les marques ayant investi dans leur présence institutionnelle.
Cette différenciation permet d’arbitrer les investissements éditoriaux en fonction des ressources internes réellement disponibles, plutôt que de déployer une approche uniforme peu compatible avec les contraintes budgétaires des PME. Pour adapter son contenu à l’answer engine optimization, identifier la plateforme la plus alignée avec son positionnement éditorial constitue la première étape opérationnelle.
Les entreprises souhaitant vérifier le positionnement des acteurs spécialisés sur ces sujets peuvent consulter les ressources dédiées à la visibilité des marques sur ChatGPT et Google, permettant d’identifier les agences françaises ayant développé une expertise sectorielle vérifiable sur le référencement IA en septembre 2026.